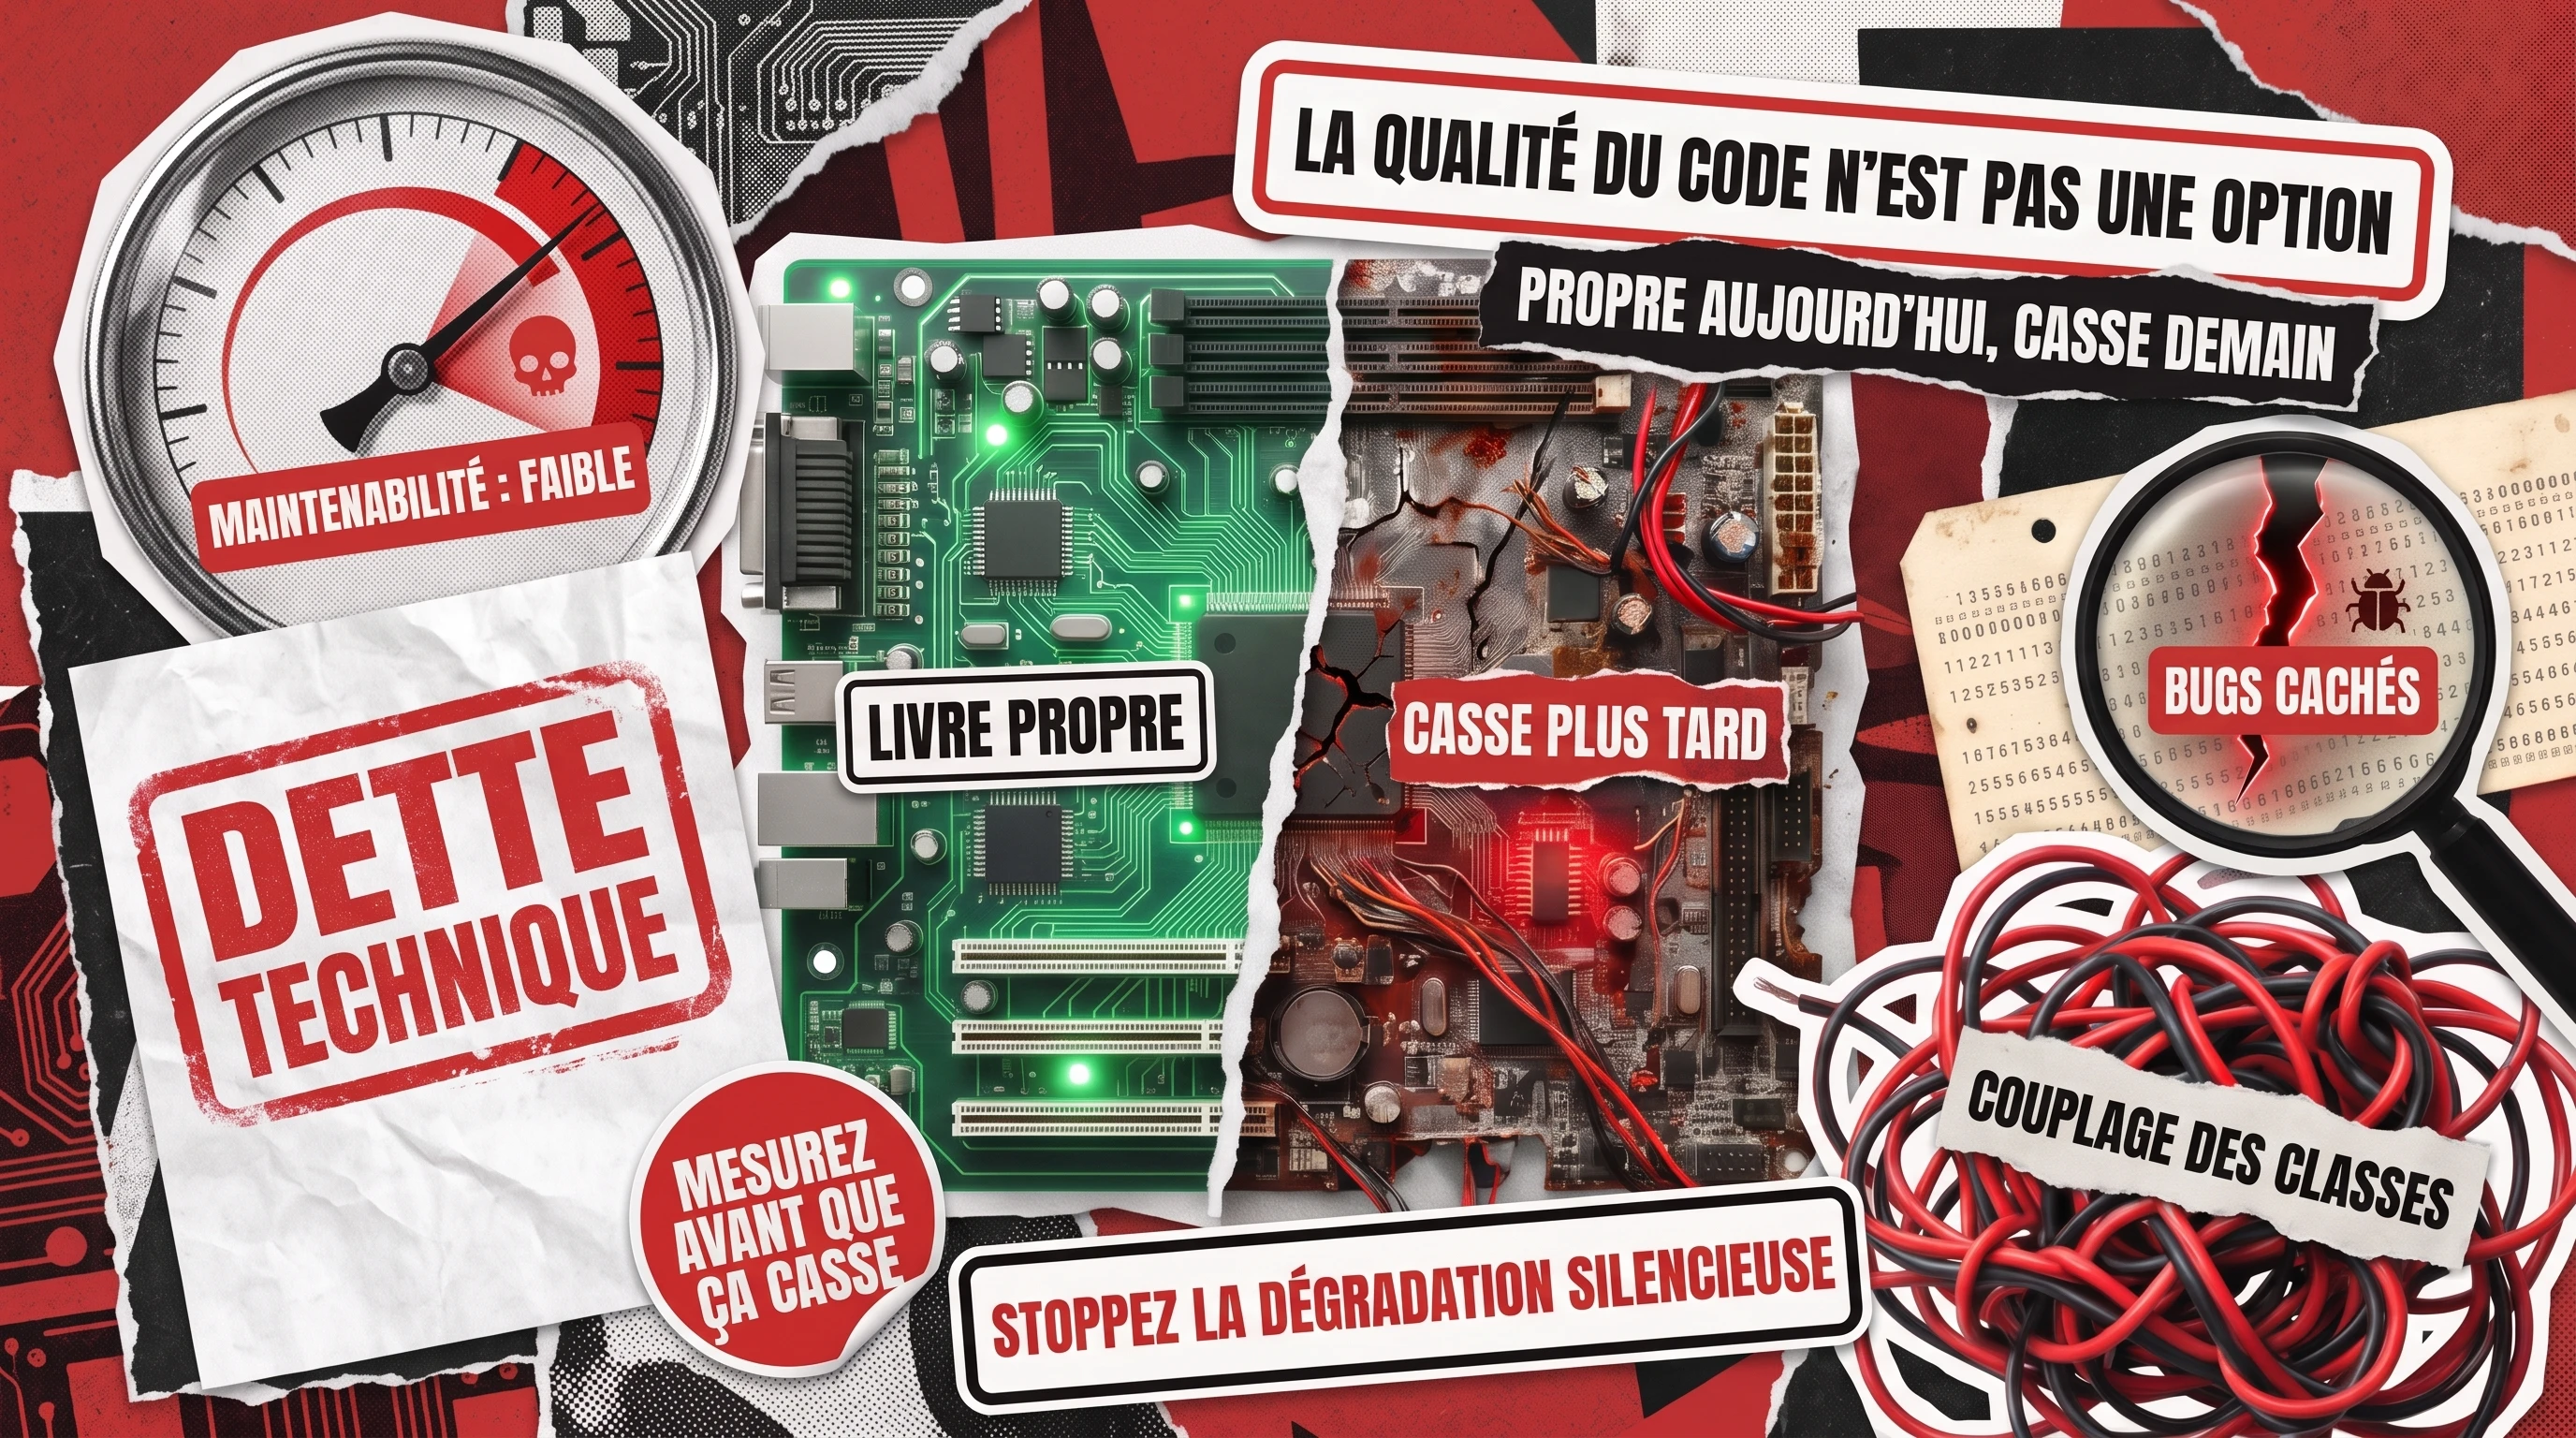
Tout responsable d’ingénierie finit par affronter la même décision silencieuse : livrer plus vite maintenant, ou ralentir et réparer le code qui se trouve dessous. Choisissez trop souvent la vitesse et la facture arrive plus tard, sous forme de délais manqués, d’incidents en production et de fonctionnalités qui prennent trois fois plus de temps que prévu. La qualité du code est la variable qui décide de l’ampleur de cette facture et, contrairement au moral de l’équipe ou au timing du marché, elle peut être mesurée, suivie et maîtrisée.
L’enjeu n’a rien d’abstrait. Dans l’enquête Stack Overflow Developer Survey 2025, menée auprès de plus de 49 000 développeurs dans 177 pays, la dette technique est arrivée en tête des sources de frustration, citée par 62 % des répondants, soit environ le double de la plainte suivante. Pour les fondateurs, les managers et les responsables de projet qui se demandent s’il faut investir dans un nettoyage, un audit ou un partenaire de développement, la première étape est de comprendre ce qu’est vraiment la qualité et comment lui donner un chiffre.
Ce que signifie vraiment la qualité du code
La qualité du code est le degré auquel un logiciel est correct, lisible, maintenable, sûr et assez efficace pour évoluer en toute sécurité au fil du temps. C’est une question distincte de celle de savoir si l’application fonctionne aujourd’hui. Une fonctionnalité peut passer tous les tests et reposer malgré tout sur un code source d’une qualité si médiocre que le prochain changement casse deux choses que personne n’avait touchées.
Les praticiens divisent généralement la qualité en deux moitiés. La qualité externe couvre ce que voient les utilisateurs et les parties prenantes, à savoir la correction, la performance et la fiabilité. La qualité interne couvre ce que seuls les ingénieurs voient, y compris la structure, le nommage, la couverture de tests et l’étroitesse avec laquelle les modules dépendent les uns des autres. La qualité interne est la moitié qui détermine en silence votre vitesse future, car elle fixe le prix de chaque changement que vous ferez un jour. Un produit qui semble correct aux utilisateurs peut être presque figé en interne, où chaque nouvelle demande implique de démêler du code qui n’a jamais été conçu pour grandir.
Pourquoi la qualité du code est une métrique métier
Une mauvaise qualité interne ne reste pas longtemps un problème d’ingénierie. Elle refait surface dans le compte de résultat, sous forme de livraisons plus lentes, de coûts de support plus élevés et de revenus perdus à cause des interruptions et des incidents de sécurité. Selon une analyse du Forbes Technology Council de 2025 portant sur une étude de Tricentis, 40 % des organisations affirment qu’une mauvaise qualité logicielle leur coûte plus d’un million de dollars par an, et 45 % des entreprises américaines déclarent des pertes supérieures à cinq millions de dollars par an.
Les équipes qui mesurent la qualité du code de façon constante obtiennent trois avantages qui manquent à leurs concurrents. Elles bénéficient d’une alerte précoce avant qu’un module ne devienne impossible à maintenir, d’une base objective pour arbitrer entre refactorisation et nouvelles fonctionnalités, et d’une réponse défendable lorsqu’un conseil d’administration ou un acquéreur demande à quel point la base de code est réellement saine. Ce dernier point représente un vrai enjeu financier, car la dette technique est l’une des premières choses qu’une équipe sérieuse de due diligence examine lors d’une levée de fonds ou d’une acquisition. Si vous voulez une manière structurée de traduire cette dette en heures et en euros, notre guide sur comment mesurer la dette technique détaille le calcul étape par étape.
Comment mesurer la qualité du code : quatre métriques solides
Répondre à la question de savoir comment mesurer la qualité du code commence par rejeter les chiffres de vanité. Les lignes de code et le simple nombre de commits renseignent sur le volume, pas sur la santé, et ils récompensent le mauvais comportement. Les quatre métriques ci-dessous ont survécu à des décennies d’usage parce que chacune correspond à un mode de défaillance précis, et toutes les quatre sont calculées automatiquement par des outils comme Visual Studio Code Metrics pour .NET, SonarQube et leurs équivalents dans d’autres technologies.
Une analyse rigoureuse de la qualité du code lit ces quatre métriques ensemble, de sorte qu’aucun chiffre isolé ne puisse cacher un problème. Une couverture de tests élevée ne veut pas dire grand-chose si la complexité échappe à tout contrôle, et un score de maintenabilité propre peut malgré tout masquer une chaîne d’héritage fragile en dessous. Voici ce que chacune vous dit réellement et où commence la zone de danger.
Indice de maintenabilité
L’indice de maintenabilité agrège la complexité, les lignes de code et d’autres facteurs en un score unique de 0 à 100. Dans Visual Studio, 20 à 100 s’affiche en vert, 10 à 19 en jaune et 0 à 9 en rouge. C’est le moyen le plus rapide de décider quels fichiers méritent l’attention en premier, et il fonctionne mieux comme ligne de tendance que comme note absolue. Un indice qui baisse lentement au fil des versions est l’un des signes précoces les plus clairs qu’une base de code commence à se dégrader.
Complexité cyclomatique
La complexité cyclomatique compte les chemins indépendants à travers un morceau de code, c’est-à-dire en pratique le nombre de décisions que prend une méthode. Une méthode notée de 1 à 10 est simple à lire et à tester avec un nombre raisonnable de cas de test. Dès qu’elle dépasse 10, le nombre de tests nécessaires pour la couvrir croît vite, et au-delà de 20 la méthode devient un refuge fiable pour les bugs cachés. Découper une méthode surchargée en plusieurs méthodes ciblées est généralement le gain de qualité le moins coûteux à la portée d’une équipe.
Profondeur d'héritage
La profondeur d’héritage mesure combien de classes parentes se trouvent au-dessus d’une classe donnée. Les hiérarchies peu profondes, d’environ un à trois niveaux, sont faciles à raisonner et sûres à modifier. Les chaînes profondes rendent le comportement difficile à retracer, car un changement dans une classe de base lointaine peut modifier une sous-classe d’une manière que personne n’avait prévue au moment de l’édition. Lorsque vous voyez la profondeur grimper version après version, privilégier la composition à l’héritage est la façon habituelle de l’aplatir de nouveau.
Couplage de classes
Le couplage de classes compte de combien d’autres classes une classe donnée dépend pour accomplir son travail. Un couplage faible garde les changements locaux, de sorte que corriger un composant n’oblige pas à en modifier une douzaine d’autres. Un couplage élevé est ce qui rend une base de code fragile, où une petite demande se transforme en silence en une semaine passée à démêler des dépendances. Réduire le couplage grâce à des interfaces claires et des frontières bien définies est l’une des améliorations structurelles à plus fort effet de levier qu’une équipe puisse réaliser.
Comment améliorer la qualité du code
Savoir comment améliorer la qualité du code tient moins des réécritures héroïques que de l’installation de quelques disciplines qui attrapent les problèmes tant qu’ils sont encore bon marché à corriger. Les quatre pratiques ci-dessous fonctionnent en séquence : les standards préviennent les problèmes, les revues les attrapent, la refactorisation élimine ceux qui passent au travers, et un audit indépendant vous dit la vérité lorsque votre propre équipe est trop proche pour la voir.

Standards de codage et linting
Les standards transforment le « bon code » d’une opinion en une liste de contrôle qu’une machine peut faire respecter. Un guide de style partagé plus un linter automatique, comme ESLint pour JavaScript, Ruff pour Python ou les analyseurs intégrés de .NET, bloquent des catégories entières de défauts avant même qu’un humain n’ouvre la pull request. Le bénéfice s’accumule avec le temps. Lorsque chaque fichier suit les mêmes conventions, les nouveaux ingénieurs montent en puissance plus vite et les relecteurs peuvent consacrer leur attention à la logique et à la conception plutôt qu’aux détails de mise en forme.
Revues de code
Un processus de revue discipliné reste la pratique de qualité au meilleur rendement dont disposent la plupart des équipes, car une seconde paire d’yeux expérimentés attrape des défauts de conception qu’aucun linter ne comprend. Les revues efficaces sont courtes, fréquentes et concentrées sur la courte liste des choses qui comptent vraiment, et c’est pourquoi une liste de contrôle de revue de code partagée l’emporte à chaque fois sur un retour improvisé. Les équipes qui manquent de capacité senior pour relire de façon constante font souvent appel à un partenaire externe via un service de revue de code dédié pour tenir le niveau sans ralentir la livraison.
Refactorisation
La refactorisation améliore la structure interne sans changer le comportement externe, et elle est plus efficace comme habitude régulière que comme grand nettoyage trimestriel. L’approche fiable consiste à refactoriser par petites étapes sous couverture de tests, afin que chaque changement reste sûr et réversible. Cela compte plus que jamais maintenant que les assistants d’IA génèrent de grands volumes de code plausible mais peu structuré. La même enquête Stack Overflow de 2025 a révélé que 66 % des développeurs sont frustrés par des sorties d’IA « presque justes, mais pas tout à fait », et 45 % rapportent que déboguer du code généré par IA prend plus de temps que prévu. Nettoyer ces sorties via un nettoyage de code IA structuré empêche un prototype rapide de durcir en dette permanente.
Audit indépendant
Les équipes internes peinent à juger leur propre code de manière objective, car elles portent les mêmes hypothèses qui ont créé les problèmes au départ. Un audit de développement logiciel indépendant apporte un regard senior neuf et une méthodologie reproductible, et il produit une liste priorisée de ce qu’il faut corriger accompagnée d’une estimation du coût de chaque correction en heures. Les audits sont rentables avant une levée de fonds, une acquisition ou une montée en charge importante, et ils valent tout autant la peine d’être programmés pour des bases de code chargées en IA, comme l’explique en détail notre décryptage d’un audit de code vibe.
Comment empêcher la qualité du code de se dégrader
L’amélioration n’est que la moitié du travail. Sans système pour consolider les acquis, la qualité s’érode d’elle-même à mesure que les délais se resserrent et que de petits raccourcis s’accumulent en silence. Une assurance qualité du code durable signifie intégrer les contrôles dans votre pipeline pour que les standards s’appliquent d’eux-mêmes, plutôt que de dépendre de quelqu’un qui se souvienne d’y tenir un jour de livraison chargé.
Une poignée de contrôles maintient la ligne de tendance dans le bon sens :
- Placez des barrières de qualité dans l’intégration continue, afin qu’un build échoue quand la couverture baisse ou que la complexité franchit un seuil convenu.
- Suivez l’indice de maintenabilité comme une tendance au fil des versions, et traitez un déclin soutenu comme un déclencheur de planification.
- Réservez une part fixe de chaque sprint, souvent de 15 à 20 %, pour rembourser la dette avant qu’elle ne s’accumule.
- Rendez la revue et les tests non négociables pour chaque fusion, y compris les petites, car de nombreuses régressions se cachent dans des changements « triviaux ».
- Réauditez périodiquement, surtout après une croissance rapide, un changement d’équipe ou une salve de développement assisté par IA.
Les équipes qui maintiennent la qualité stable pendant des années sont rarement celles qui comptent les ingénieurs individuels les plus doués. Ce sont celles qui ont fait de la qualité une propriété du système, imposée par l’outillage et le processus, plutôt qu’une affaire de volonté quotidienne qui s’étiole sous la pression.
Faire de la qualité un système
La qualité n’est pas quelque chose qu’on achète une fois et qu’on oublie ; c’est une discipline que l’on entretient. Les équipes qui la traitent comme une propriété mesurable et pilotée de leur logiciel livrent plus vite, dorment mieux et défendent leur valorisation quand cela compte. Si votre base de code grandit plus vite que votre confiance en elle, une équipe externe expérimentée peut vous donner une base honnête et un plan concret sur lequel agir. Redwerk audite, sauve et renforce des logiciels depuis plus de 20 ans, en .NET, en Python et sur d’autres technologies, alors contactez-nous pour discuter de l’état de votre code aujourd’hui.
FAQ
Qu'est-ce que la qualité du code ?
La qualité du code, c’est à quel point un logiciel est correct, lisible, maintenable, sûr et efficace, jugé par la sûreté et le coût avec lesquels il peut évoluer au fil du temps. Un code de haute qualité continue de fonctionner de façon prévisible à mesure qu’il grandit, tandis qu’un code de basse qualité devient plus coûteux et plus risqué à toucher à chaque version.
Comment mesure-t-on la qualité du code ?
On la mesure avec une combinaison de métriques automatiques et de revue humaine. Les métriques les plus fiables sont l’indice de maintenabilité, la complexité cyclomatique, la profondeur d’héritage et le couplage de classes, idéalement suivies comme des tendances au fil des versions et associées à la couverture de tests et aux taux de défauts, plutôt que lues isolément.
Comment puis-je améliorer la qualité du code ?
Commencez par des standards de codage imposés et un linting automatique, ajoutez des revues par les pairs régulières, refactorisez par petites étapes sous couverture de tests, et faites appel à un audit indépendant lorsque vous avez besoin d’une base objective. Intégrer ces contrôles dans votre pipeline d’intégration continue est ce qui empêche les acquis de se perdre avec le temps.
Quelles métriques utilise-t-on pour analyser la qualité du code ?
Les métriques courantes incluent l’indice de maintenabilité, la complexité cyclomatique, la profondeur d’héritage, le couplage de classes, la couverture de tests, la duplication de code et la densité de défauts. En utiliser plusieurs ensemble empêche qu’un seul score ne masque un vrai problème ailleurs dans la base de code.
Qu'est-ce qu'un bon indice de maintenabilité ?
Sur l’échelle de 0 à 100 utilisée par des outils comme Visual Studio, un score de 20 à 100 est considéré comme sain (vert), de 10 à 19 comme moyen (jaune) et de 0 à 9 comme mauvais (rouge). Une valeur supérieure à 85 indique en général un code très maintenable. La tendance compte autant que le chiffre absolu, si bien qu’un indice qui baisse de façon soutenue est un signal d’alerte même lorsqu’il est encore dans le vert.
Découvrez comment nous avons audité une application de cartographie réseau multiplateforme avant sa sortie et aidé à atteindre 90 % de maintenabilité du code