- 28 Juillet, 2026
- 11 lecture min
Un test d'adéquation en quatre parties pour les outils internes : quand le vibe coding est sûr à utiliser, quand il échoue silencieusement, et comment tracer la limite avant de passer à l'échelle.
- 24 Juillet, 2026
- 14 lecture min
Un audit d'infrastructure informatique vérifie l'hébergement, les bases de données, le CI/CD, les sauvegardes, le réseau et le coût du cloud. Voici exactement quoi vérifier et comment le mener.
- 23 Juillet, 2026
- 12 lecture min
Un audit de performance web identifie ce qui ralentit votre site, des Core Web Vitals aux serveurs et scripts, puis classe les corrections selon leur impact sur la vitesse et le chiffre d'affaires.
- 23 Juillet, 2026
- 15 lecture min
Un audit de l'infrastructure cloud révèle trois choses sur AWS, Azure et GCP : mauvaises configurations, dépenses excessives et fragilité. Voici ce qu'il vérifie, comment il fonctionne et quand vous en avez besoin.
- 21 Juillet, 2026
- 12 lecture min
La qualité du code décide de la rapidité, du coût et de la sûreté avec lesquels votre logiciel peut évoluer ; voici comment la mesurer avec quatre métriques éprouvées, l'améliorer et l'empêcher de se dégrader au fil du temps.
- 15 Juillet, 2026
- 14 lecture min
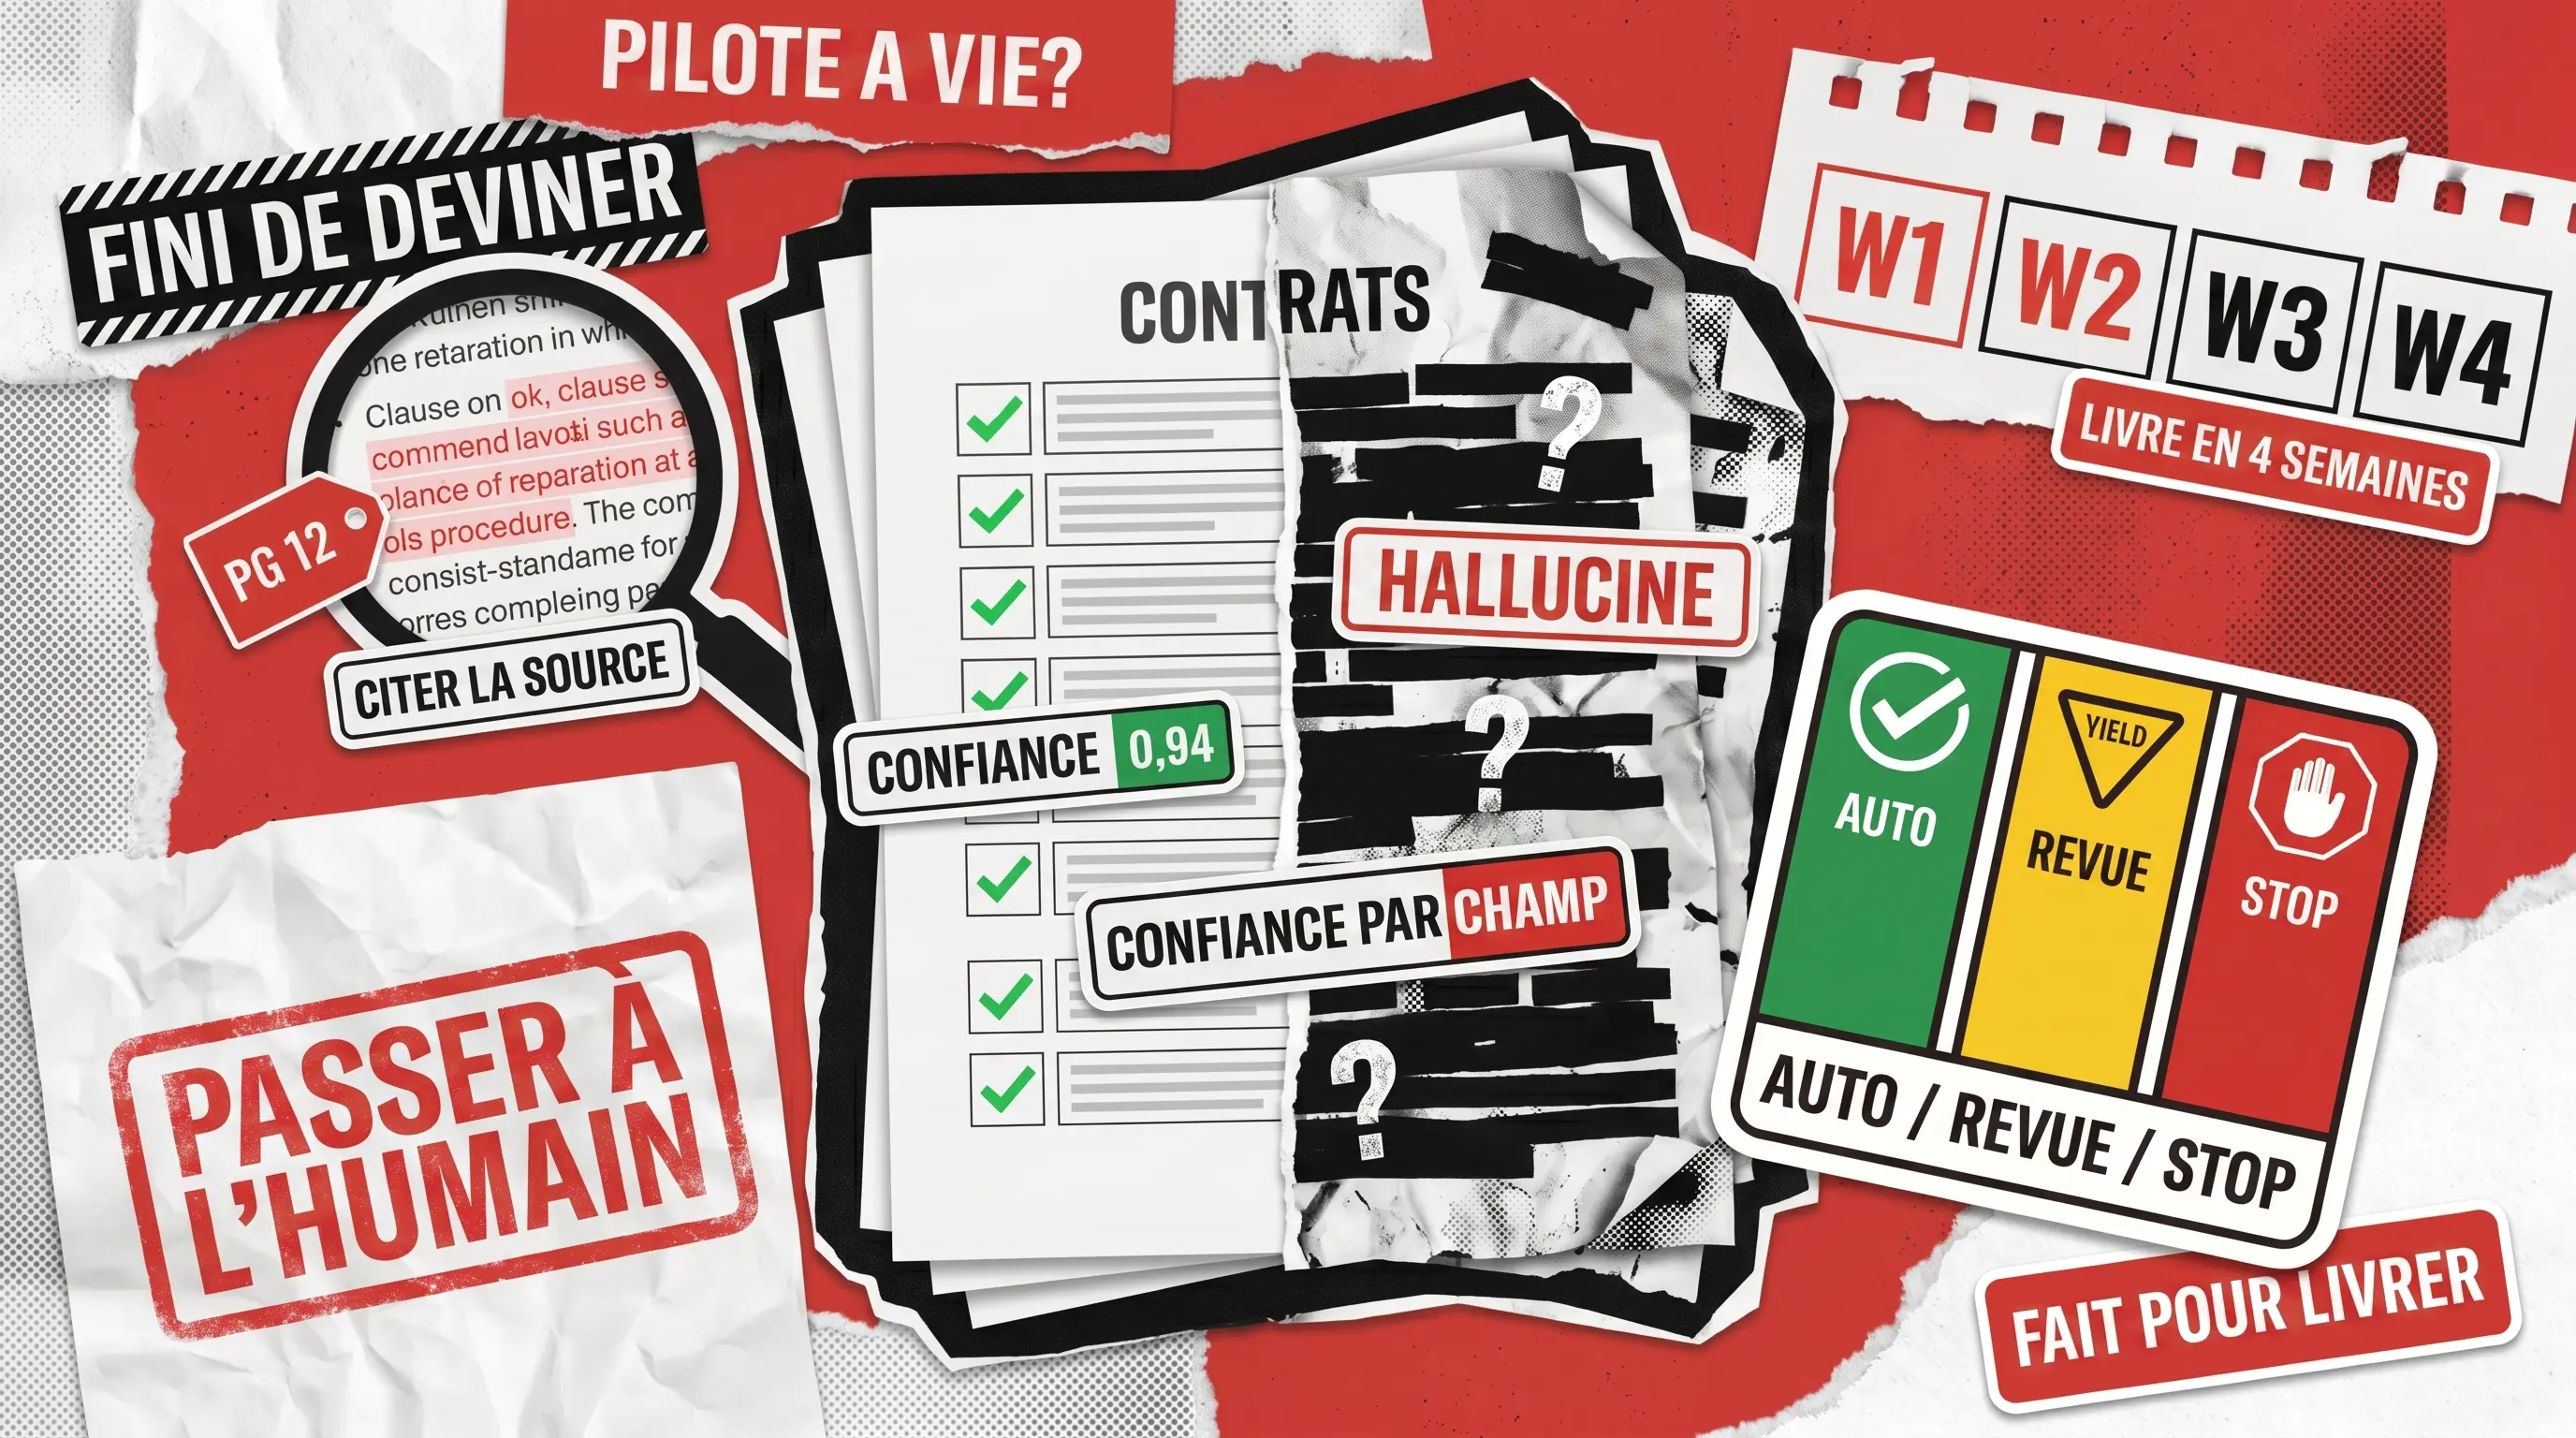
Un pipeline de revue de documents tient ses promesses ou ne les tient pas, et l’écart entre les deux n’a généralement rien à voir avec le choix du modèle. Tout se joue dans les décisions d’architecture prises dès la première semaine, les patterns de prompts choisis selon le cas d’usage et une stratégie de routage par confiance qui survit au contact des documents réels.
- 09 Juillet, 2026
- 13 lecture min
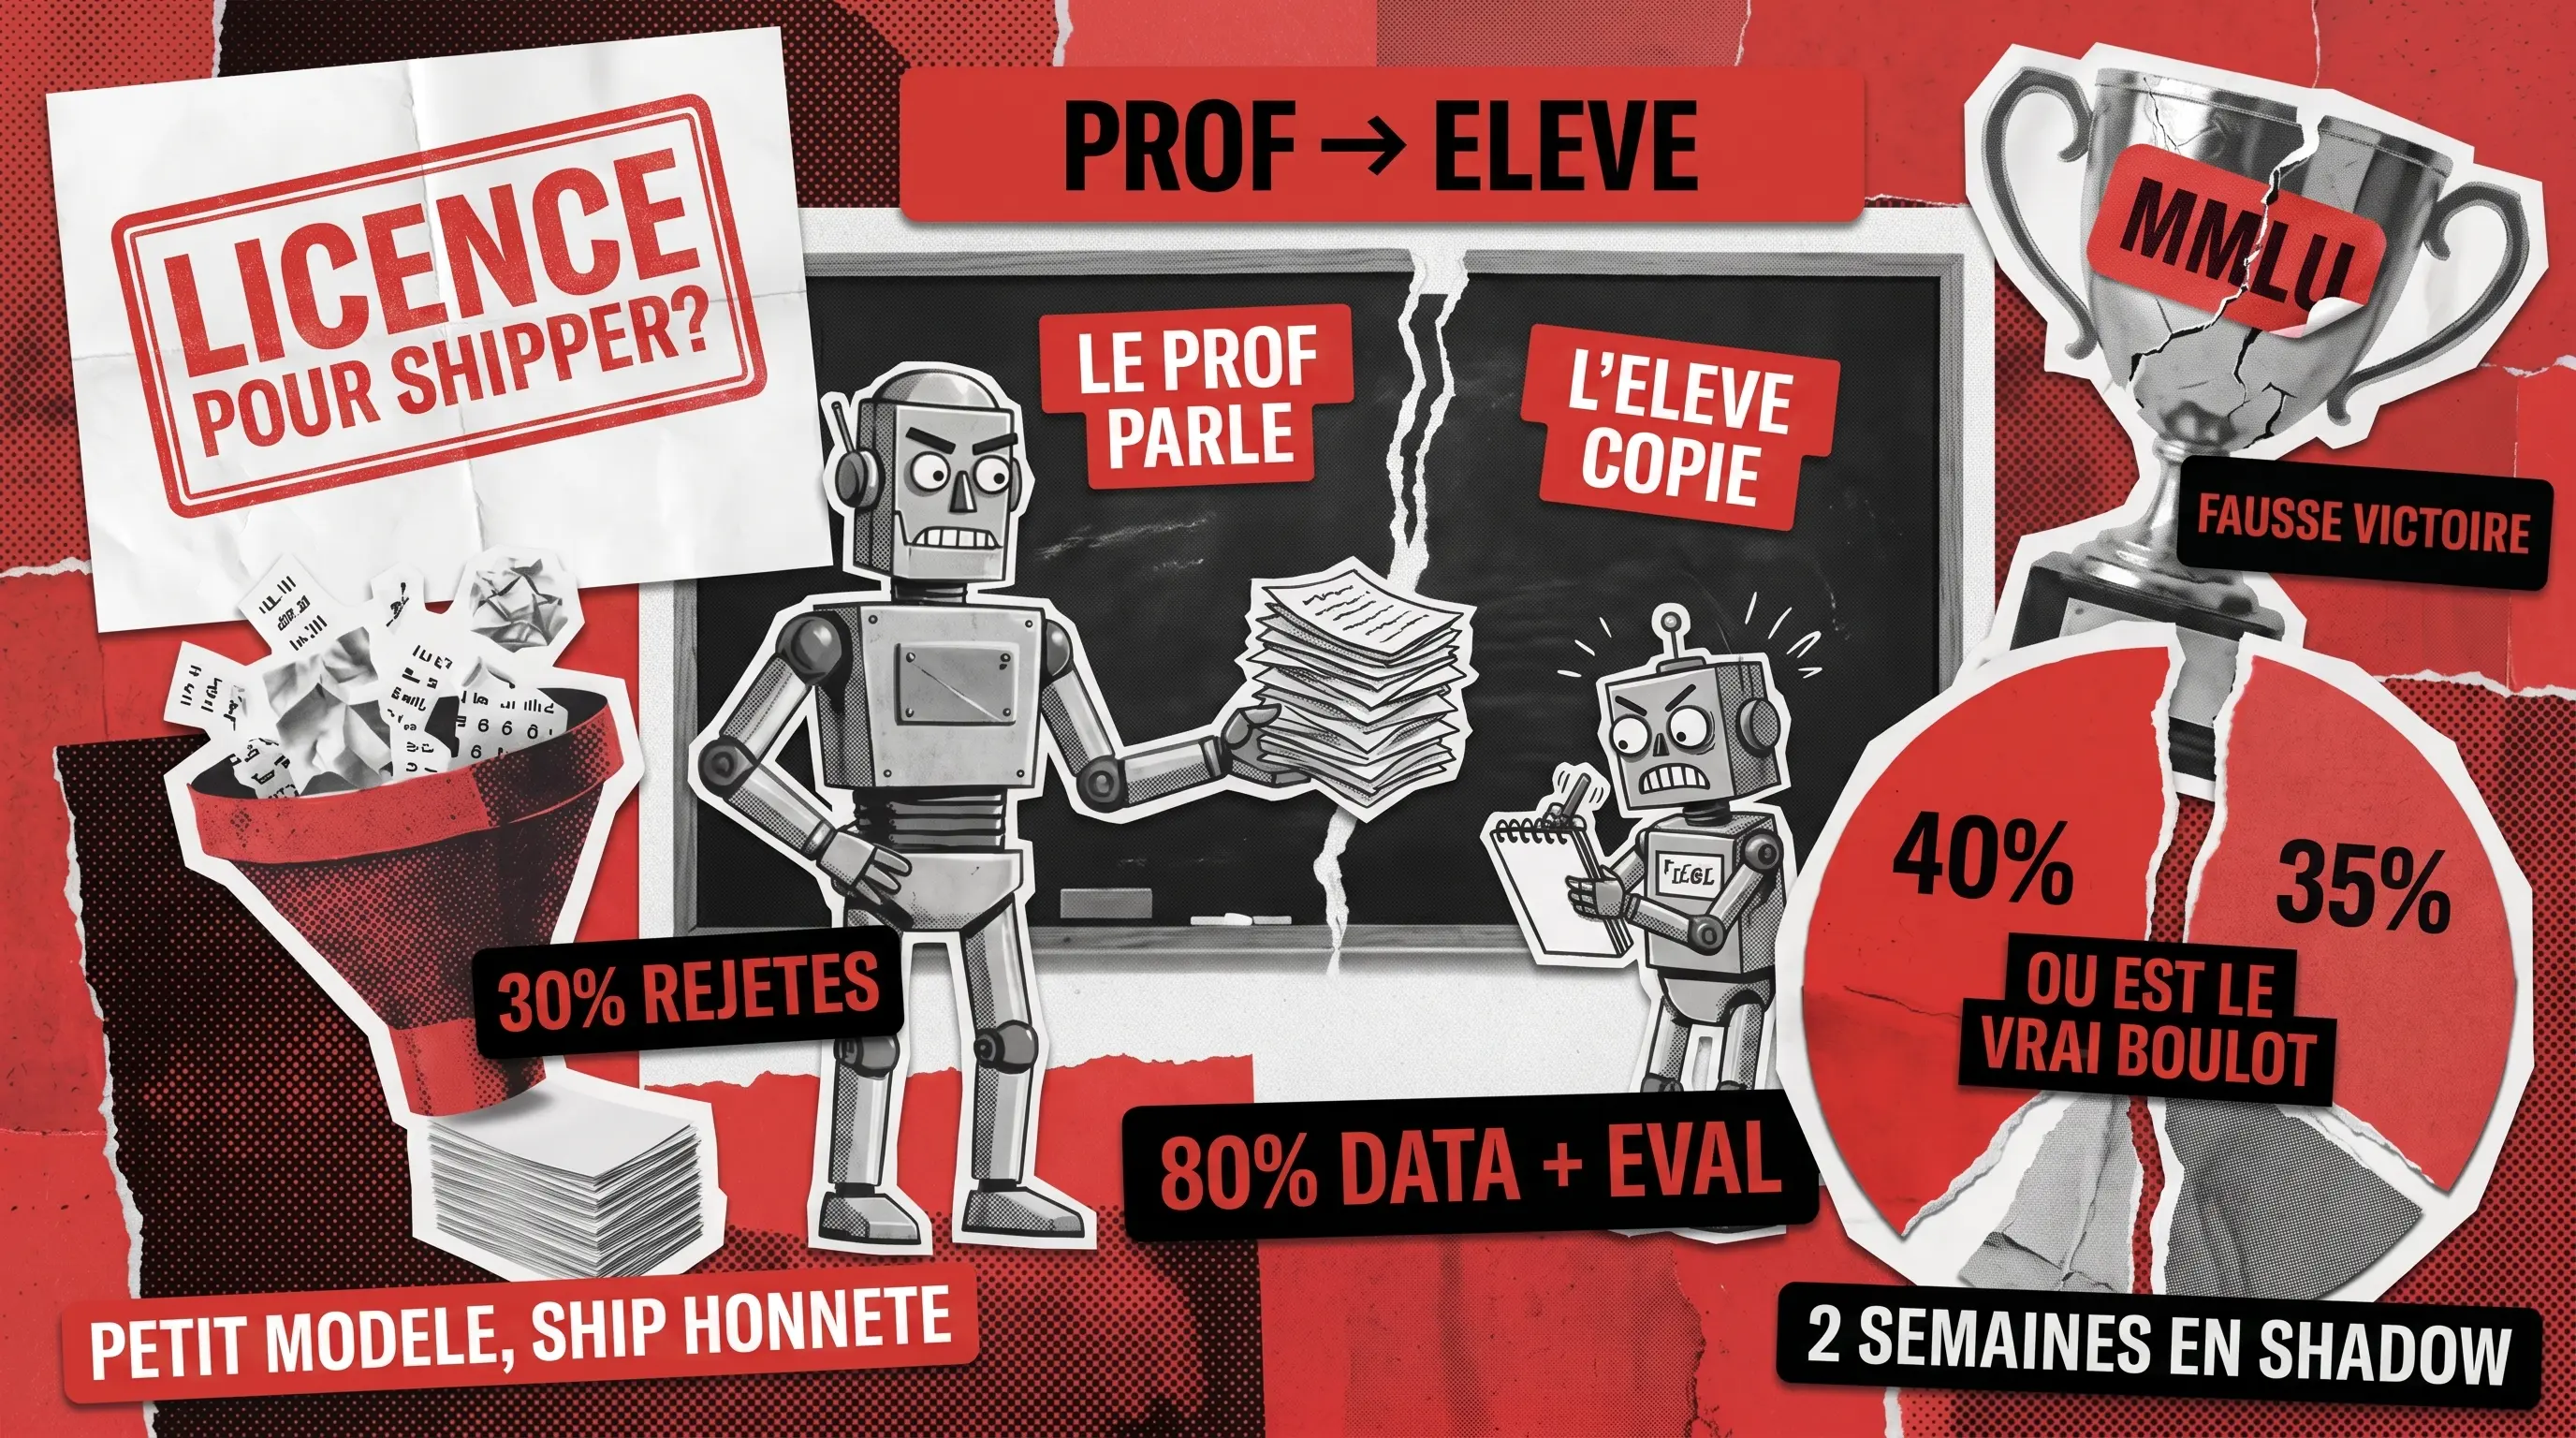
La plupart des tutoriels font ressembler la distillation d'un LLM à un projet de week-end. Quarante lignes de code Hugging Face, un échange BERT vers DistilBERT, et c'est fait. Le véritable pipeline représente une échelle de travail différente. Vous choisissez un enseignant que vous êtes légalement autorisé à utiliser, générez un jeu de données synthétique qui ne nuit pas à l'élève, entraînez avec LoRA, et prouvez que l'élève n'a pas régressé silencieusement sur les entrées que vos utilisateurs envoient réellement.
- 23 Juin, 2026
- 12 lecture min
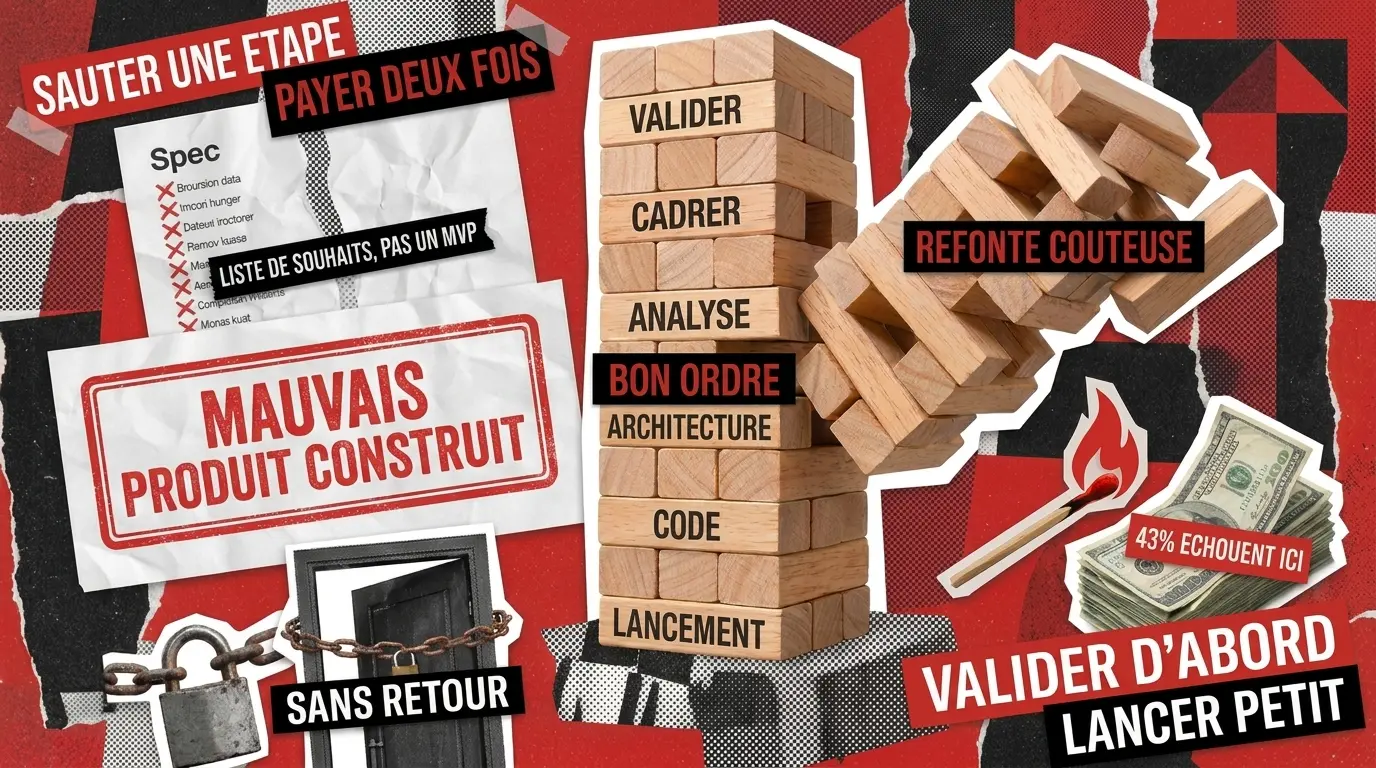
La plupart des produits SaaS qui échouent ont été construits correctement. Ils ont résolu le mauvais problème, ou ont résolu le bon problème dans le mauvais ordre, et le code a parfaitement fonctionné tout au long du processus.
- 23 Juin, 2026
- 14 lecture min
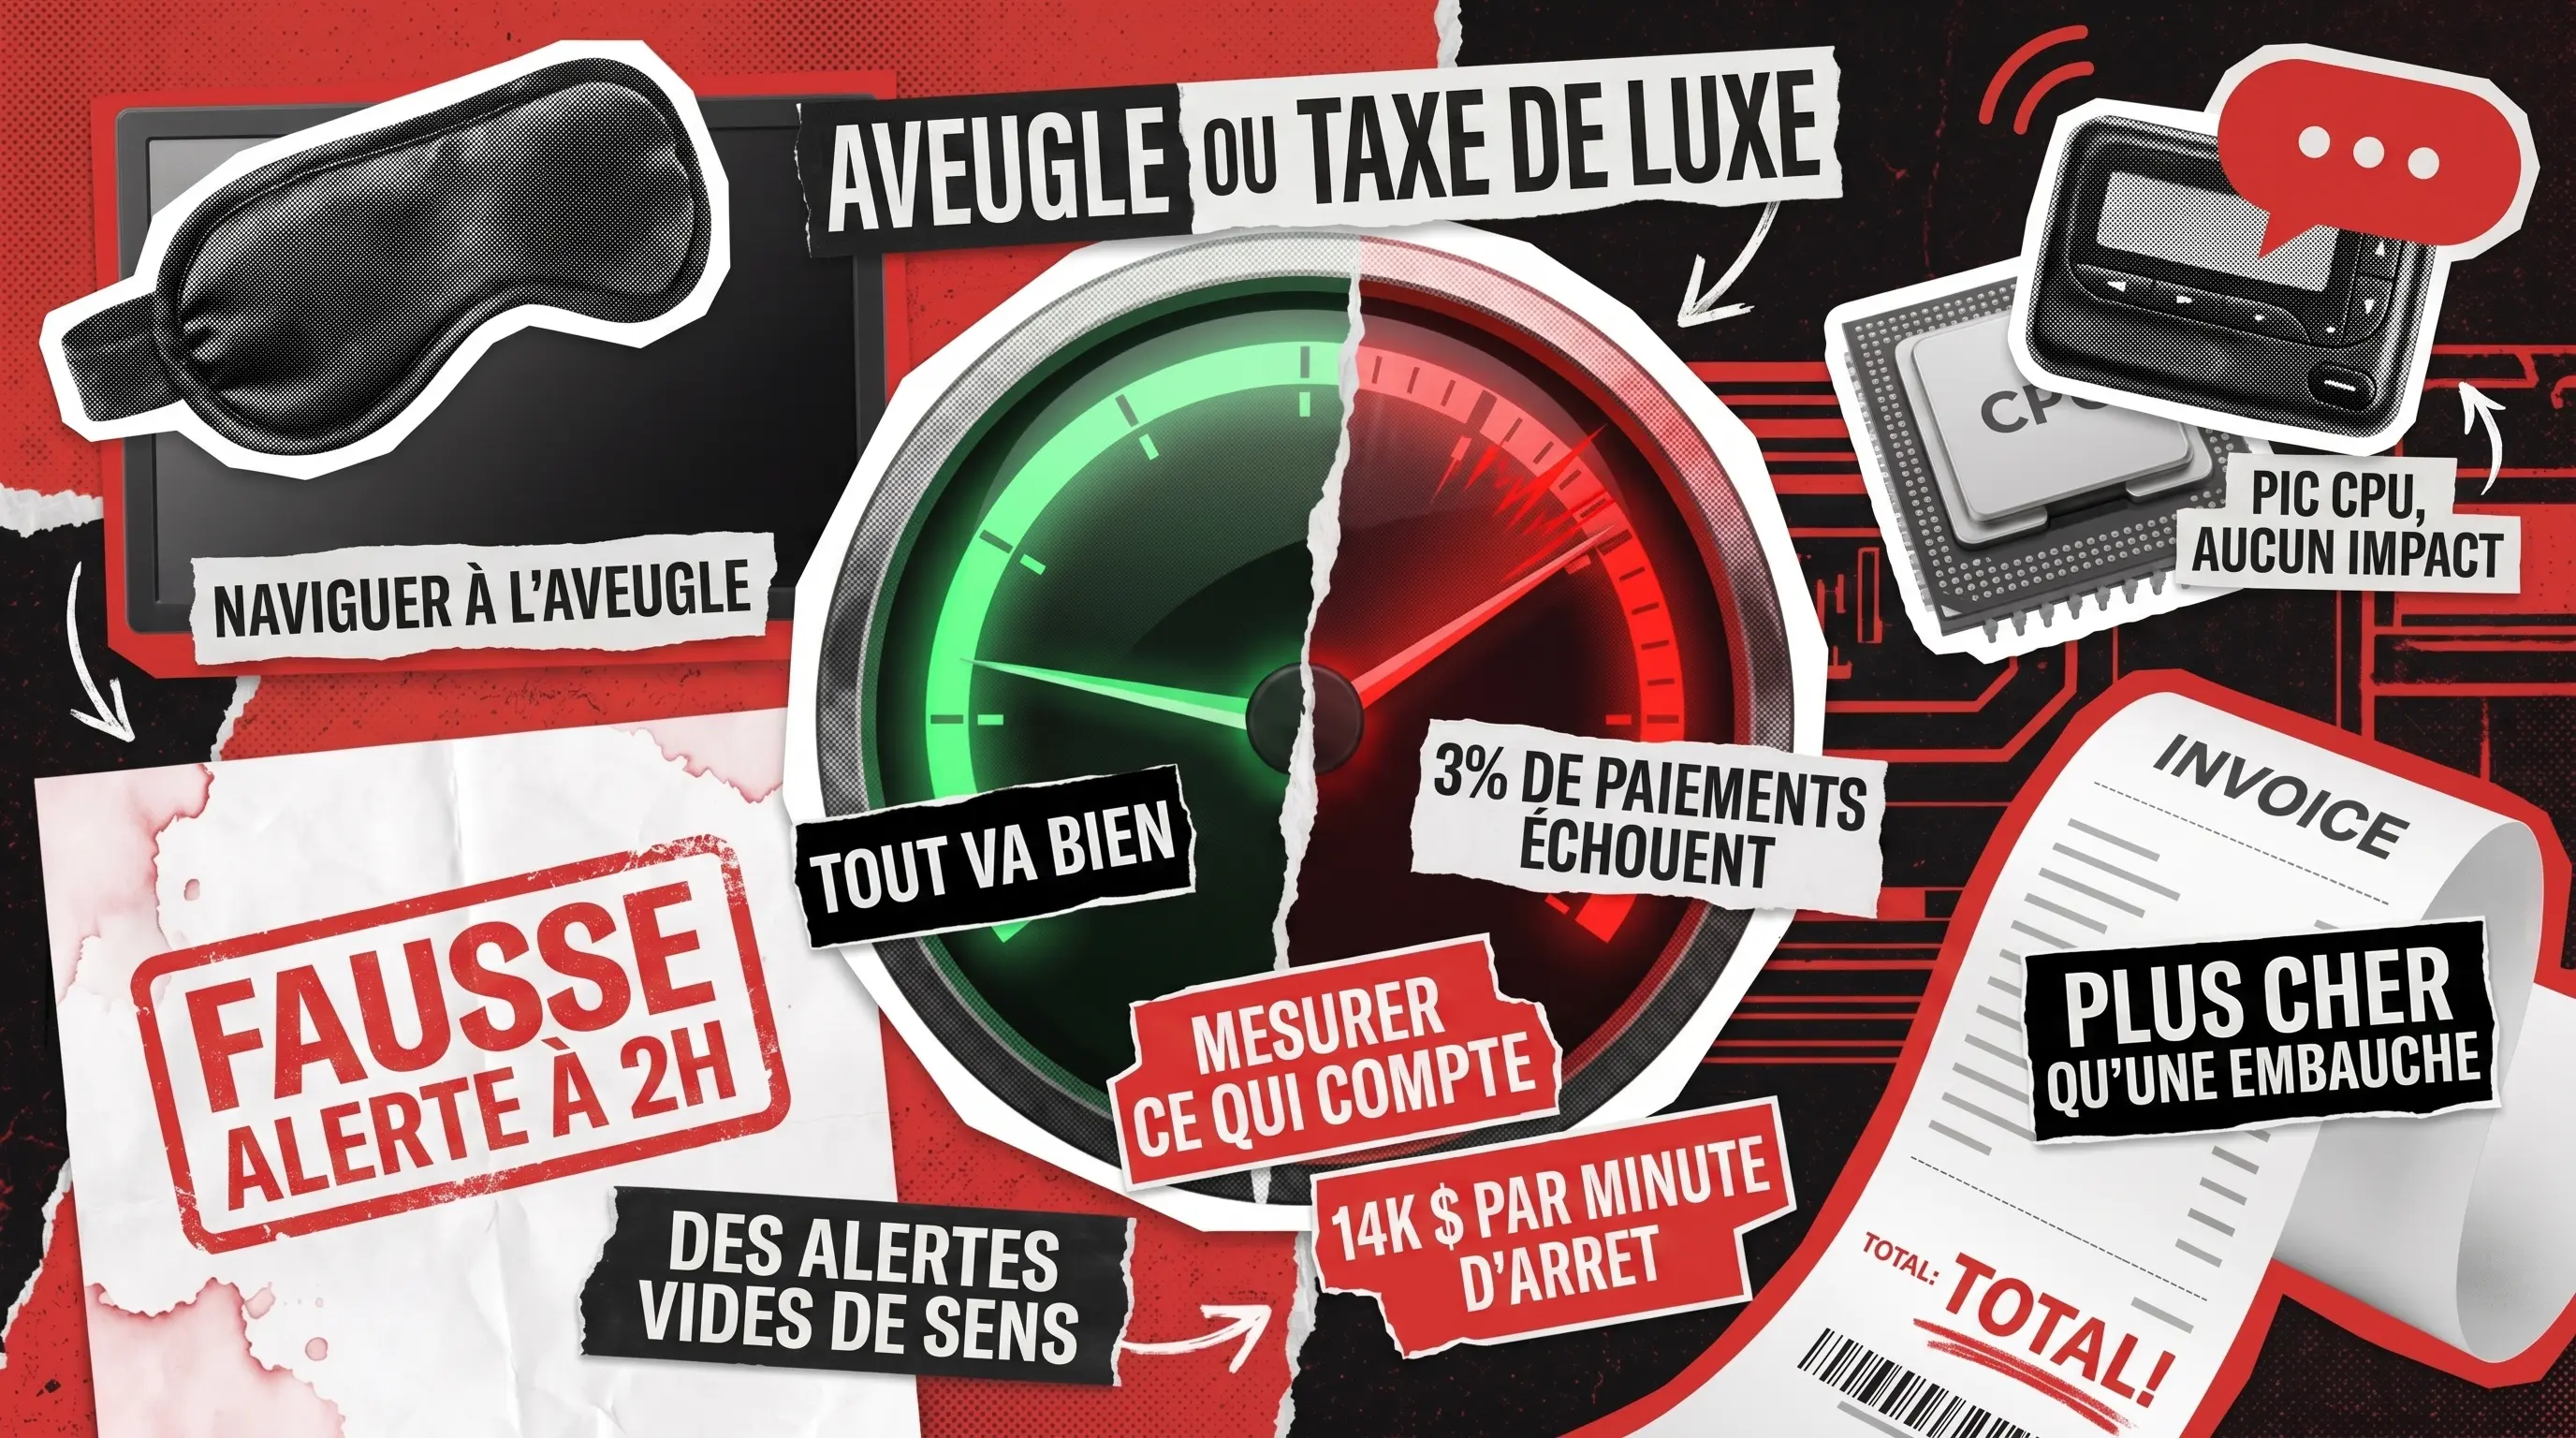
Le parcours vers une observabilité SaaS optimale commence généralement par l'un de ces deux pièges extrêmes et accidentels. Au départ, la plupart des fondateurs optent pour la solution de facilité. Ils ne suivent absolument rien, déploient des fonctionnalités à une vitesse fulgurante et supposent naïvement que tout va bien jusqu'à ce qu'un utilisateur exaspéré dénonce un bug critique sur les réseaux sociaux. Paniqués, ils basculent brutalement dans l'autre extrême : l'achat d'une plateforme de supervision massive et professionnelle avant même d'atteindre 500 utilisateurs actifs.
- 19 Juin, 2026
- 15 lecture min
Un concurrent vient de déployer une fonctionnalité d'IA. Maintenant, vos utilisateurs en veulent une, votre conseil d'administration ne cesse de vous transmettre des démonstrations, et un investisseur veut connaître votre « feuille de route IA » dès le prochain appel. Vous avez un produit qui fonctionne et des clients qui le paient, et l'idée de le démanteler pour y ajouter de l'IA ressemble à l'échange d'une vraie entreprise contre une expérience scientifique.